flowchart TD
    F(("Renda")):::latente
    E1(("ε₁")):::erro
    E2(("ε₂")):::erro
    E3(("ε₃")):::erro
    X1["Educação"]:::obs
    X2["Cultura"]:::obs
    X3["Alimentação"]:::obs

    %% Ligações invisíveis apenas para separar o fator dos termos específicos.
    F ~~~ E1
    F ~~~ E2
    F ~~~ E3

    E1 --> X1
    E2 --> X2
    E3 --> X3

    F -->|ℓ₁| X1
    F -->|ℓ₂| X2
    F -->|ℓ₃| X3

    classDef latente fill:#fff,stroke:#C44E52,stroke-width:2px,color:#C44E52
    classDef obs fill:#fff,stroke:#4C78A8,stroke-width:2px,color:#4C78A8
    classDef erro fill:#fff,stroke:#888,stroke-width:1.5px,color:#555
6 Análise fatorial
Suponha que registramos, para várias famílias, o gasto mensal em educação, em cultura e em alimentação. As três variáveis caminham juntas, pois famílias com mais renda gastam mais em tudo. Mesmo sem que a renda apareça na nossa tabela, sabemos que ela explica boa parte dos três gastos.
A análise fatorial (AF) parte dessa ideia e supõe que por trás das variáveis medidas existem algumas poucas variáveis não observáveis, os fatores comuns, e que é a ação delas que produz as correlações que vemos. No exemplo dos gastos, um único fator, a renda familiar, influencia os três ao mesmo tempo. Cada gasto guarda ainda uma parcela própria, que não é compartilhada com os demais e junta tanto o que é particular daquela variável quanto o erro de medida.
Repare para onde apontam as setas da Figura 6.1. Todas chegam às variáveis observadas, porque são o fator e os termos específicos que as geram. As cargas \(\ell_j\) medem a força de cada influência, e estimá-las sem nunca observar o que está no alto do diagrama é o problema deste capítulo.
6.1 O modelo fatorial ortogonal
Definição 6.1 (Modelo fatorial ortogonal) Seja \(\boldsymbol{x}\) um vetor aleatório de \(p\) variáveis observadas, com vetor de médias \(\boldsymbol{\mu}\) e matriz de covariâncias \(\boldsymbol{\Sigma}\). O modelo fatorial ortogonal com \(m\) fatores comuns, \(m < p\), escreve
\[ \boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon} \tag{6.1}\]
em que \(\boldsymbol{L}\) é a matriz \(p \times m\) de cargas fatoriais, \(\boldsymbol{F} = (F_1, \dots, F_m)^T\) reúne os fatores comuns e \(\boldsymbol{\epsilon} = (\epsilon_1, \dots, \epsilon_p)^T\) reúne os fatores específicos. O elemento \(\ell_{jk}\) de \(\boldsymbol{L}\) mede quanto o fator \(F_k\) pesa sobre a variável \(X_j\).
O modelo supõe ainda que
\[ \operatorname{E}\left[\boldsymbol{F}\right] = \boldsymbol{0}, \qquad \operatorname{Cov}\left(\boldsymbol{F}\right) = \boldsymbol{I}_m \]
\[ \operatorname{E}\left[\boldsymbol{\epsilon}\right] = \boldsymbol{0}, \qquad \operatorname{Cov}\left(\boldsymbol{\epsilon}\right) = \boldsymbol{\Psi} = \operatorname{diag}\left(\psi_1, \dots, \psi_p\right) \]
\[ \operatorname{Cov}\left(\boldsymbol{F}, \boldsymbol{\epsilon}\right) = \boldsymbol{0} \]
A exigência \(\operatorname{Cov}\left(\boldsymbol{F}\right) = \boldsymbol{I}_m\) é uma convenção. Como ninguém observa os fatores, eles não têm unidade própria, e fixamos a variância de cada um em 1. Se dobrássemos um fator e dividíssemos suas cargas por 2, nada mudaria em \(\boldsymbol{x}\). As covariâncias nulas entre os fatores dão ao modelo o nome de ortogonal e também são uma escolha, da qual veremos como abrir mão na rotação.
Já a suposição de que \(\boldsymbol{\Psi}\) é diagonal é onde está o conteúdo do modelo. Ela diz que a parte específica de uma variável não tem relação com a parte específica de outra, e então duas variáveis só podem andar juntas por meio dos fatores comuns. No exemplo dos gastos, isso significa que educação e cultura se correlacionam apenas porque ambas dependem da renda. Se as famílias que valorizam cultura também investissem mais em educação, independentemente do quanto ganham, essa associação extra não caberia num modelo que tem só a renda como fator. É uma suposição que os dados podem desmentir, e mais adiante veremos como testá-la.
Teorema 6.1 (Estrutura da matriz de covariâncias) Sob as suposições da Definição 6.1, a matriz de covariâncias de \(\boldsymbol{x}\) é
\[ \boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi} \tag{6.2}\]
Prova. Como \(\boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon}\) e ambos os termos têm média zero, cada esperança abaixo é uma matriz de covariâncias, dada pelas suposições do modelo. Os dois termos cruzados desaparecem e sobra
\[ \begin{aligned} \boldsymbol{\Sigma} &= \operatorname{E}\left[(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})^T\right] \\ &= \boldsymbol{L}\underbrace{\operatorname{E}\left[\boldsymbol{F}\boldsymbol{F}^T\right]}_{\operatorname{Cov}\left(\boldsymbol{F}\right) = \boldsymbol{I}_m}\boldsymbol{L}^T + \boldsymbol{L}\underbrace{\operatorname{E}\left[\boldsymbol{F}\boldsymbol{\epsilon}^T\right]}_{\operatorname{Cov}\left(\boldsymbol{F}, \boldsymbol{\epsilon}\right) = \boldsymbol{0}} + \underbrace{\operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{F}^T\right]}_{\operatorname{Cov}\left(\boldsymbol{\epsilon}, \boldsymbol{F}\right) = \boldsymbol{0}}\boldsymbol{L}^T + \underbrace{\operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{\epsilon}^T\right]}_{\operatorname{Cov}\left(\boldsymbol{\epsilon}\right) = \boldsymbol{\Psi}} \\ &= \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi} \end{aligned} \]
A Equação 6.2 divide a matriz de covariâncias em duas partes. A parcela \(\boldsymbol{L}\boldsymbol{L}^T\) é compartilhada e tem posto \(m\), bem menor que \(p\); a parcela \(\boldsymbol{\Psi}\) é diagonal e própria de cada variável. Como \(\boldsymbol{\Psi}\) não contribui para nada fora da diagonal, toda a covariância entre variáveis diferentes fica por conta de \(\boldsymbol{L}\boldsymbol{L}^T\). Para \(j \neq j'\),
\[ \operatorname{Cov}\left(X_j, X_{j'}\right) = \sum_{k=1}^m \ell_{jk}\ell_{j'k} \]
Na diagonal, a mesma equação reparte a variância de cada variável. Escrevendo \(\sigma_{jj} = \operatorname{Var}\left(X_j\right)\) e tomando o elemento \((j,j)\) de \(\boldsymbol{L}\boldsymbol{L}^T\),
\[ \sigma_{jj} = \underbrace{\sum_{k=1}^m \ell_{jk}^2}_{h_j^2} + \psi_j \]
A quantidade \(h_j^2\) é a comunalidade de \(X_j\), a parte da variância que a variável divide com as demais por meio dos fatores comuns. O que resta, \(\psi_j\), é a variância específica, e inclui tanto aquilo que é próprio da variável quanto o erro de medida. Quando a AF é feita sobre a matriz de correlações, todas as variâncias valem 1 e a leitura fica ainda mais direta, com \(h_j^2 + \psi_j = 1\).
Proposição 6.1 (Cargas e correlações) Sob as suposições da Definição 6.1, a carga \(\ell_{jk}\) é a covariância entre a variável \(X_j\) e o fator \(F_k\), e a correlação entre eles é
\[ \operatorname{Cov}\left(X_j, F_k\right) = \ell_{jk}, \qquad \operatorname{Corr}\left(X_j, F_k\right) = \frac{\ell_{jk}}{\sqrt{\sigma_{jj}}} \]
Em particular, quando \(X_j\) está padronizada, sua carga é a própria correlação com o fator,
\[ \operatorname{Corr}\left(X_j, F_k\right) = \ell_{jk} \]
Nesse caso, as cargas ficam entre \(-1\) e \(1\).
Prova. Como \(\operatorname{E}\left[\boldsymbol{F}\right] = \boldsymbol{0}\), a definição de covariância e a substituição de \(\boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon}\) dão
\[ \begin{aligned} \operatorname{Cov}\left(\boldsymbol{x}, \boldsymbol{F}\right) &= \operatorname{E}\left[(\boldsymbol{x}- \boldsymbol{\mu})\boldsymbol{F}^T\right] \\ &= \operatorname{E}\left[(\boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon})\boldsymbol{F}^T\right] \\ &= \boldsymbol{L}\operatorname{E}\left[\boldsymbol{F}\boldsymbol{F}^T\right] + \operatorname{E}\left[\boldsymbol{\epsilon}\boldsymbol{F}^T\right] \\ &= \boldsymbol{L}\operatorname{Cov}\left(\boldsymbol{F}\right) + \operatorname{Cov}\left(\boldsymbol{\epsilon}, \boldsymbol{F}\right) \\ &= \boldsymbol{L}\boldsymbol{I}_m + \boldsymbol{0}\\ &= \boldsymbol{L} \end{aligned} \]
Tomando o elemento \((j,k)\), obtemos \(\operatorname{Cov}\left(X_j, F_k\right) = \ell_{jk}\). Como \(\operatorname{Var}\left(F_k\right) = 1\), basta dividir a covariância por \(\sqrt{\sigma_{jj}}\) para obter a correlação. Com \(X_j\) padronizada, \(\sigma_{jj} = 1\).
A escolha da escala segue a mesma ideia da ACP (Seção 4.2). Costumamos trabalhar com a matriz de correlações quando as unidades ou as escalas das variáveis são diferentes. A matriz de covariâncias faz sentido quando as variáveis têm escalas comparáveis e queremos preservar suas diferenças de variabilidade. Para escrever o modelo na escala padronizada, seja \(\boldsymbol{D}\) a matriz diagonal dos desvios padrão. As variáveis padronizadas \(\boldsymbol{z} = \boldsymbol{D}^{-1}(\boldsymbol{x}- \boldsymbol{\mu})\) satisfazem
\[ \boldsymbol{z} = \underbrace{\boldsymbol{D}^{-1}\boldsymbol{L}}_{\boldsymbol{L}_z}\boldsymbol{F} + \underbrace{\boldsymbol{D}^{-1}\boldsymbol{\epsilon}}_{\boldsymbol{\epsilon}_z} \]
que é de novo um modelo fatorial, com os mesmos fatores, as cargas de cada variável divididas pelo seu desvio padrão e variâncias específicas \(\boldsymbol{\Psi}_z = \boldsymbol{D}^{-1}\boldsymbol{\Psi}\boldsymbol{D}^{-1}\), que continuam formando uma matriz diagonal. A estrutura de covariâncias correspondente é
\[ \boldsymbol{\rho}= \boldsymbol{L}_z\boldsymbol{L}_z^T + \boldsymbol{\Psi}_z \]
Aviso
Nos exemplos a seguir, trabalharemos com a matriz de correlações amostral \(\boldsymbol{R}\). Nesses exemplos, escreveremos \(\boldsymbol{L}\) e \(\boldsymbol{\Psi}\) para as cargas e variâncias específicas na escala padronizada, omitindo o índice \(z\).
Exemplo 6.1 (Gastos familiares) Retomemos os três gastos da abertura do capítulo, agora padronizados, com a matriz de correlações
\[ \boldsymbol{R}= \begin{pmatrix} 1.00 & 0.56 & 0.48 \\ 0.56 & 1.00 & 0.42 \\ 0.48 & 0.42 & 1.00 \end{pmatrix} \]
Vamos procurar um único fator comum, \(m = 1\). Nesse caso \(\boldsymbol{L}\) é um vetor de três cargas e o modelo diz que \(\rho_{jj'} = \ell_j\ell_{j'}\) para \(j \neq j'\), o que dá três equações para três incógnitas
\[ \ell_1\ell_2 = 0.56, \qquad \ell_1\ell_3 = 0.48, \qquad \ell_2\ell_3 = 0.42 \]
Multiplicando as duas primeiras e dividindo pela terceira, os fatores \(\ell_2\) e \(\ell_3\) se cancelam e sobra
\[ \ell_1^2 = \frac{(\ell_1\ell_2)(\ell_1\ell_3)}{\ell_2\ell_3} = \frac{0.56 \times 0.48}{0.42} = 0.64 \]
Logo \(\ell_1 = 0.8\), e as outras duas saem por substituição, \(\ell_2 = 0.7\) e \(\ell_3 = 0.6\). As comunalidades são \(h_1^2 = 0.64\), \(h_2^2 = 0.49\) e \(h_3^2 = 0.36\), e as variâncias específicas, \(\psi_j = 1 - h_j^2\), valem \(0.36\), \(0.51\) e \(0.64\).
\[ \boldsymbol{L} = \begin{pmatrix} 0.8 \\ 0.7 \\ 0.6 \end{pmatrix}, \qquad \boldsymbol{\Psi} = \begin{pmatrix} 0.36 & 0 & 0 \\ 0 & 0.51 & 0 \\ 0 & 0 & 0.64 \end{pmatrix} \]
Multiplicando de volta, \(\boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\) devolve \(\boldsymbol{R}\) exatamente. Assim, a matriz de resíduos, dada pela diferença entre a matriz observada e a reproduzida pelo modelo, é nula
\[ \boldsymbol{R}- \left(\boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\right) = \boldsymbol{0} \]
Todos os resíduos são zero, tanto na diagonal quanto fora dela. O gasto em educação é o mais ligado à renda, com 64% da sua variância explicada pelo fator; o gasto em alimentação é o menos ligado, com 36%, o que faz sentido, já que alimentação tem um piso que independe de quanto a família ganha.
6.2 Estimação
Na prática não conhecemos \(\boldsymbol{\Sigma}\), só a sua estimativa \(\boldsymbol{S}\), e o problema passa a ser encontrar \(\hat{\boldsymbol{L}}\) e \(\hat{\boldsymbol{\Psi}}\) tais que \(\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}\) fique o mais perto possível dela. Apresentaremos os métodos em termos da matriz de covariâncias; com variáveis padronizadas, essa matriz é \(\boldsymbol{R}\).
6.2.1 Componentes principais
A decomposição espectral (Teorema 2.1) permite escrever a matriz de covariâncias populacional em forma matricial ou como uma soma das contribuições de cada componente,
\[ \boldsymbol{\Sigma}= \boldsymbol{E}\boldsymbol{\Lambda}\boldsymbol{E}^T = \sum_{k=1}^p \lambda_k \boldsymbol{e}_k\boldsymbol{e}_k^T \]
em que \(\boldsymbol{E}\) reúne os autovetores ortonormais nas colunas e \(\boldsymbol{\Lambda} = \operatorname{diag}\left(\lambda_1, \dots, \lambda_p\right)\) contém os autovalores em ordem decrescente. Como os autovalores de uma matriz de covariâncias são não negativos, podemos tomar \(\boldsymbol{\Lambda}^{1/2} = \operatorname{diag}\left(\sqrt{\lambda_1}, \dots, \sqrt{\lambda_p}\right)\) e reescrever a decomposição como
\[ \boldsymbol{\Sigma}= \left(\boldsymbol{E}\boldsymbol{\Lambda}^{1/2}\right)\left(\boldsymbol{E}\boldsymbol{\Lambda}^{1/2}\right)^T \]
Essa expressão já tem a forma \(\boldsymbol{L}\boldsymbol{L}^T\), e a coluna \(k\) de \(\boldsymbol{E}\boldsymbol{\Lambda}^{1/2}\) é \(\sqrt{\lambda_k}\boldsymbol{e}_k\). Se os primeiros \(m\) componentes concentram a maior parte da variabilidade, usamos essas \(m\) colunas para construir as cargas e atribuímos o que faltar na diagonal às variâncias específicas. Na amostra, fazemos essa construção a partir dos autovalores e autovetores de \(\boldsymbol{S}\).
Definição 6.2 (Solução por componentes principais) Sejam \((\hat{\lambda}_k, \hat{\boldsymbol{e}}_k)\), \(k = 1, \dots, p\), os pares de autovalor e autovetor de \(\boldsymbol{S}\), com \(\hat{\lambda}_1 \ge \dots \ge \hat{\lambda}_p\). A solução por componentes principais com \(m\) fatores é
\[ \hat{\boldsymbol{L}} = \left[\sqrt{\hat{\lambda}_1}\hat{\boldsymbol{e}}_1 \ \middle|\ \sqrt{\hat{\lambda}_2}\hat{\boldsymbol{e}}_2 \ \middle|\ \cdots \ \middle|\ \sqrt{\hat{\lambda}_m}\hat{\boldsymbol{e}}_m \right] \]
\[ \hat{\boldsymbol{\Psi}} = \operatorname{diag}\left(\boldsymbol{S}- \hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T\right), \qquad \hat{\psi}_j = s_{jj} - \sum_{k=1}^m \hat{\ell}_{jk}^2 \]
Com variáveis padronizadas, substituímos \(\boldsymbol{S}\) por \(\boldsymbol{R}\) e \(s_{jj}\) por 1, usando os autovalores e autovetores de \(\boldsymbol{R}\).
Por construção, as variâncias específicas da Definição 6.2 absorvem o que faltar na diagonal, tornando nulos os resíduos nessa posição. Para avaliar o ajuste, olhamos então para os resíduos fora da diagonal, cuja soma de quadrados pode ser limitada pelos autovalores que deixamos de fora.
Proposição 6.2 (Limite para os resíduos) Na solução por componentes principais com \(m\) fatores da Definição 6.2, a soma dos quadrados dos resíduos fora da diagonal satisfaz
\[ \sum_{j \neq j'} \left(s_{jj'} - \sum_{k=1}^m \hat{\ell}_{jk}\hat{\ell}_{j'k}\right)^2 \le \sum_{k=m+1}^p \hat{\lambda}_k^2 \]
Prova. Considere a parte descartada da decomposição espectral,
\[ \boldsymbol{E} = \boldsymbol{S}- \hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T = \sum_{k=m+1}^p \hat{\lambda}_k\hat{\boldsymbol{e}}_k\hat{\boldsymbol{e}}_k^T \]
Para \(j \neq j'\), o elemento \(e_{jj'}\) é o resíduo \(s_{jj'} - \sum_{k=1}^m \hat{\ell}_{jk}\hat{\ell}_{j'k}\), pois \(\hat{\boldsymbol{\Psi}}\) não contribui fora da diagonal. A soma dos quadrados desses elementos não pode exceder a soma dos quadrados de todos os elementos de \(\boldsymbol{E}\). Pela ortonormalidade dos autovetores e pela Definição 2.6,
\[ \sum_{j \neq j'} e_{jj'}^2 \le \|\boldsymbol{E}\|_F^2 = \sum_{k=m+1}^p \hat{\lambda}_k^2 \]
A Proposição 6.2 dá um critério prático. Se a soma dos quadrados dos autovalores descartados for pequena, a soma dos quadrados dos resíduos também será. A comparação deve levar em conta a escala das variáveis; com variáveis padronizadas, os resíduos medem diretamente as diferenças entre as correlações observadas e as reproduzidas.
Os autovalores retidos também têm leitura direta nas cargas. Somando os quadrados de uma linha de \(\hat{\boldsymbol{L}}\), obtemos a comunalidade estimada de \(X_j\). Somando os de uma coluna, obtemos a parcela da variância total atribuída ao fator correspondente.
Proposição 6.3 (Autovalores e variância explicada) Na solução por componentes principais, a soma dos quadrados das cargas do fator \(k\) é o autovalor retido correspondente,
\[ \sum_{j=1}^p \hat{\ell}_{jk}^2 = \hat{\lambda}_k \]
Assim, a proporção da variância total explicada pelo fator \(k\) é \(\hat{\lambda}_k / \operatorname{tr}\left(\boldsymbol{S}\right)\).
Prova. A coluna \(k\) de \(\hat{\boldsymbol{L}}\) é \(\sqrt{\hat{\lambda}_k}\,\hat{\boldsymbol{e}}_k\), com \(\hat{\boldsymbol{e}}_k^T\hat{\boldsymbol{e}}_k = 1\). Logo,
\[ \sum_{j=1}^p \hat{\ell}_{jk}^2 = \hat{\lambda}_k\,\hat{\boldsymbol{e}}_k^T\hat{\boldsymbol{e}}_k = \hat{\lambda}_k \]
Basta dividir por \(\operatorname{tr}\left(\boldsymbol{S}\right)\), a variância total das variáveis.
Exemplo 6.2 Vamos aplicar a Definição 6.2 aos gastos familiares do Exemplo 6.1, para os quais já conhecemos a resposta exata. Como os gastos estão padronizados, usamos \(\boldsymbol{R}\) no lugar de \(\boldsymbol{S}\). Seus autovalores são \(1.975\), \(0.593\) e \(0.431\). Retendo o primeiro, as cargas estimadas são \(\sqrt{1.975}\,\hat{\boldsymbol{e}}_1\), o que dá
\[ \hat{\boldsymbol{L}}_{\text{CP}} = \begin{pmatrix} 0.847 \\ 0.817 \\ 0.768 \end{pmatrix} \]
contra o valor exato \((0.8,\ 0.7,\ 0.6)^T\). Todas as cargas vieram infladas, e as comunalidades também, que ficaram em \(0.718\), \(0.668\) e \(0.591\) no lugar de \(0.64\), \(0.49\) e \(0.36\). Subtraindo de \(\boldsymbol{R}\) a matriz reproduzida pelo modelo, obtemos a matriz de resíduos
\[ \boldsymbol{R}- \left(\hat{\boldsymbol{L}}_{\text{CP}}\hat{\boldsymbol{L}}_{\text{CP}}^T + \hat{\boldsymbol{\Psi}}\right) = \begin{pmatrix} 0 & -0.132 & -0.171 \\ -0.132 & 0 & -0.208 \\ -0.171 & -0.208 & 0 \end{pmatrix} \]
Na solução exata do Exemplo 6.1, todos os resíduos eram nulos. Aqui, apenas a diagonal é reproduzida exatamente; os resíduos negativos fora dela mostram que as correlações foram superestimadas. Reproduzir as variâncias, portanto, não garante reproduzir as correlações.
As cargas ficam superestimadas porque a ACP procura direções que retenham a variância total das variáveis, incluindo a parte específica. Ao considerar essa parcela na extração dos fatores, o método atribui a eles mais variância do que os fatores comuns explicam. Na AF, buscamos explicar a covariância compartilhada, distinguindo a variância explicada pelos fatores comuns da variância específica de cada variável.
O método de componentes principais exige pouco esforço computacional e funciona razoavelmente bem quando as comunalidades são altas, pois a variância específica é pequena e a superestimação das cargas tende a ser menor. Também pode fornecer estimativas iniciais para os métodos iterativos.
6.2.2 Fatoração do eixo principal
No método de componentes principais, a diagonal de \(\boldsymbol{S}\) representa toda a variância das variáveis, incluindo a parte específica. Pelo modelo fatorial, porém, \(\boldsymbol{\Sigma}- \boldsymbol{\Psi} = \boldsymbol{L}\boldsymbol{L}^T\). Se retirássemos a parcela específica, restaria justamente a matriz que queremos representar pelas cargas. A fatoração do eixo principal segue essa ideia. Como não conhecemos \(\boldsymbol{\Psi}\), usamos estimativas das comunalidades para construir a matriz de covariâncias reduzida,
\[ \boldsymbol{S}_r = \boldsymbol{S}- \hat{\boldsymbol{\Psi}}, \qquad \hat{\psi}_j = s_{jj} - \hat{h}_j^2 \]
Sua diagonal contém as comunalidades estimadas. As covariâncias fora dela permanecem iguais às observadas, pois, pelo modelo, já são inteiramente atribuídas aos fatores comuns.
Para começar, precisamos de estimativas iniciais das comunalidades. Uma escolha usual é o coeficiente de determinação \(R_j^2\) da regressão linear de \(X_j\) nas demais variáveis, com intercepto. Esse é o \(R^2\) da regressão, que mede a proporção da variância de \(X_j\) explicada pelas demais variáveis. Ele também é o quadrado da correlação entre os valores observados e os previstos pela regressão.
No modelo fatorial, a parte específica de \(X_j\) não se correlaciona com as demais variáveis, então essa previsão se apoia na sua parte comum. Isso justifica usar \(R_j^2\) como estimativa inicial da comunalidade, ainda que ele possa representar apenas parte da variância comum. Quando \(\boldsymbol{R}\) é invertível, podemos calcular esse coeficiente diretamente pela matriz de correlações. Na escala padronizada, a variância residual da regressão é \(1/[\boldsymbol{R}^{-1}]_{jj}\) e a variância total vale 1, de modo que
\[ \hat{h}_j^2 = R_j^2 = 1 - \frac{1}{[\boldsymbol{R}^{-1}]_{jj}} \]
Essas estimativas entram na diagonal da matriz de correlações reduzida, \(\boldsymbol{R}_r = \boldsymbol{R}- \hat{\boldsymbol{\Psi}}\). Para trabalhar na escala original, multiplicamos a proporção inicial por \(s_{jj}\) e usamos \(\boldsymbol{S}_r\).
Decompomos a matriz reduzida e construímos as cargas com os \(m\) maiores autovalores e seus autovetores, como na Definição 6.2. Os autovalores retidos precisam ser positivos. Essas cargas, por sua vez, implicam comunalidades \(\hat{h}_j^2 = \sum_{k=1}^m \hat{\ell}_{jk}^2\), que podem diferir dos palpites usados na diagonal. Atualizamos a diagonal com esses valores e repetimos a extração até que as comunalidades mudem menos que uma tolerância escolhida. Se o procedimento converge, as comunalidades usadas para extrair as cargas passam a concordar com as obtidas a partir delas. A Figura 6.2 resume esse ciclo.
Exemplo 6.3 Nos dados de gastos, começamos com as comunalidades \(0.386\), \(0.343\) e \(0.264\) no lugar dos uns da diagonal de \(\boldsymbol{R}\). A primeira extração devolve cargas \((0.714,\ 0.670,\ 0.595)^T\), já mais próximas da resposta exata do que as do método de componentes principais. Seus quadrados dão novas comunalidades, aproximadamente \(0.509\), \(0.449\) e \(0.354\), que entram na diagonal para a próxima extração. As correlações fora da diagonal permanecem iguais.
Na décima iteração, as cargas são \((0.796,\ 0.703,\ 0.601)^T\). Continuando as atualizações, o procedimento converge para \((0.8,\ 0.7,\ 0.6)^T\), recuperando a solução exata do Exemplo 6.1, com \(\hat{\psi} = (0.36,\ 0.51,\ 0.64)^T\) e todos os resíduos nulos no limite.
O código abaixo reproduz essas atualizações para um fator, usando uma tolerância de \(10^{-8}\) para a maior mudança nas comunalidades.
Ver código da fatoração do eixo principal
import numpy as np

R_gastos = np.array([
    [1.00, 0.56, 0.48],
    [0.56, 1.00, 0.42],
    [0.48, 0.42, 1.00],
])
h2 = 1 - 1 / np.diag(np.linalg.inv(R_gastos))

for iteracao in range(1, 1001):
    R_reduzida = R_gastos.copy()
    np.fill_diagonal(R_reduzida, h2)

    # eigh devolve os autovalores em ordem crescente.
    autovalores, autovetores = np.linalg.eigh(R_reduzida)
    cargas_paf = np.sqrt(autovalores[-1]) * autovetores[:, -1]
    if cargas_paf[0] < 0:
        cargas_paf *= -1

    h2_novas = cargas_paf**2
    mudanca = np.max(np.abs(h2_novas - h2))
    h2 = h2_novas

    if iteracao in (1, 10):
        print(f"Iteração {iteracao}: cargas = {cargas_paf.round(3)}")
    if mudanca < 1e-8:
        break
else:
    raise RuntimeError("As comunalidades não convergiram em 1000 iterações.")

psi_paf = 1 - h2
print("Cargas finais:", cargas_paf.round(3))
print("Variâncias específicas:", psi_paf.round(3))
Iteração 1: cargas = [0.714 0.67 0.595]
Iteração 10: cargas = [0.796 0.703 0.601]
Cargas finais: [0.8 0.7 0.6]
Variâncias específicas: [0.36 0.51 0.64]Não há garantia de convergência, e a iteração pode levar alguma comunalidade acima da variância observada, produzindo uma variância específica negativa. Na escala padronizada, isso ocorre quando a comunalidade supera 1, um caso de Heywood, que discutiremos em breve.
6.2.3 Máxima verossimilhança
Nenhum dos dois métodos anteriores tem um modelo probabilístico por trás, e por isso nenhum deles permite testar o número de fatores. Para isso, precisamos de uma distribuição. Supondo que os fatores e os erros sejam normais, \(\boldsymbol{F} \sim N_m(\boldsymbol{0}, \boldsymbol{I}_m)\) e \(\boldsymbol{\epsilon} \sim N_p(\boldsymbol{0}, \boldsymbol{\Psi})\), independentes entre si, o vetor observado herda a normalidade (ver Capítulo 3) e temos \(\boldsymbol{x}\sim N_p(\boldsymbol{\mu}, \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi})\). Somando os logaritmos das densidades de uma amostra aleatória \(\boldsymbol{x}_1, \dots, \boldsymbol{x}_n\) e descartando constantes, a log-verossimilhança é
\[ \ell(\boldsymbol{\mu}, \boldsymbol{\Sigma}) = -\frac{n}{2}\ln|\boldsymbol{\Sigma}| - \frac{1}{2}\sum_{i=1}^n (\boldsymbol{x}_i - \boldsymbol{\mu})^T\boldsymbol{\Sigma}^{-1}(\boldsymbol{x}_i - \boldsymbol{\mu}) \]
Como no caso univariado, o máximo em \(\boldsymbol{\mu}\) é atingido em \(\bar{\boldsymbol{x}}\). Feita essa troca, cada parcela da soma é um número, igual ao seu próprio traço, e a propriedade cíclica do traço junta todas elas
\[ \sum_{i=1}^n (\boldsymbol{x}_i - \bar{\boldsymbol{x}})^T\boldsymbol{\Sigma}^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}}) = \operatorname{tr}\left(\boldsymbol{\Sigma}^{-1}\underbrace{\sum_{i=1}^n (\boldsymbol{x}_i - \bar{\boldsymbol{x}})(\boldsymbol{x}_i - \bar{\boldsymbol{x}})^T}_{n\boldsymbol{S}_n}\right) \]
em que \(\boldsymbol{S}_n\) é a matriz de covariâncias amostral com divisor \(n\) no lugar de \(n-1\). Sobra
\[ \ell(\boldsymbol{L}, \boldsymbol{\Psi}) = -\frac{n}{2}\left[\ln|\boldsymbol{\Sigma}| + \operatorname{tr}\left(\boldsymbol{\Sigma}^{-1}\boldsymbol{S}_n\right)\right] \]
com \(\boldsymbol{\Sigma}= \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\). Somando e subtraindo termos que não dependem dos parâmetros, maximizar \(\ell\) equivale a minimizar
\[ F(\boldsymbol{\Sigma}) = \ln|\boldsymbol{\Sigma}| + \operatorname{tr}\left(\boldsymbol{\Sigma}^{-1}\boldsymbol{S}_n\right) - \ln|\boldsymbol{S}_n| - p \]
Essa função mede a distância entre a matriz implicada pelo modelo e a observada, e cumpre aqui o papel que a soma de quadrados dos resíduos cumpre na regressão. Escrita em termos dos autovalores \(a_1, \dots, a_p\) de \(\boldsymbol{\Sigma}^{-1}\boldsymbol{S}_n\), ela vira \(F = \sum_k (a_k - \ln a_k - 1)\), e cada parcela é não negativa e só se anula quando \(a_k = 1\). Logo \(F \ge 0\), com igualdade apenas quando \(\boldsymbol{\Sigma}= \boldsymbol{S}_n\).
A minimização não tem forma fechada e sai de algoritmos iterativos. Há ainda uma redundância em \(\boldsymbol{L}\), porque girar os fatores não altera \(\boldsymbol{L}\boldsymbol{L}^T\) e, portanto, não altera \(F\), como veremos na Seção 6.4. É preciso então impor alguma condição que fixe a orientação, e a escolha convencional é exigir que \(\boldsymbol{L}^T\boldsymbol{\Psi}^{-1}\boldsymbol{L}\) seja diagonal.
O método tem uma vantagem prática que os anteriores não têm. Se uma variável muda de unidade de medida, a solução de máxima verossimilhança acompanha a mudança, reescalando a carga e a variância específica daquela variável e mais nada. É exatamente o que o modelo prevê para a padronização, e por isso analisar \(\boldsymbol{S}\) ou \(\boldsymbol{R}\) leva à mesma solução, a menos da escala das cargas. Com máxima verossimilhança, a escolha entre as duas matrizes é só uma questão de leitura.
Ter uma verossimilhança permite também comparar o modelo ajustado com a alternativa irrestrita, em que \(\boldsymbol{\Sigma}\) é qualquer matriz de covariâncias. Nessa alternativa o mínimo é \(\hat{\boldsymbol{\Sigma}} = \boldsymbol{S}_n\), com discrepância zero, e a estatística da razão de verossimilhanças fica \(2(\ell_{\text{irrestrito}} - \ell_{\text{modelo}}) = n F(\hat{\boldsymbol{\Sigma}})\), isto é, \(n\) vezes a discrepância que o modelo com \(m\) fatores deixou sobrar. Pode-se mostrar que no ótimo vale \(\operatorname{tr}\left(\hat{\boldsymbol{\Sigma}}^{-1}\boldsymbol{S}_n\right) = p\), e \(F(\hat{\boldsymbol{\Sigma}})\) se reduz ao logaritmo de uma razão de determinantes. O teste para \(H_0\): “\(m\) fatores bastam” usa
\[ \chi^2 = \left[n - 1 - \frac{2p + 4m + 5}{6}\right]\underbrace{\ln\frac{|\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}|}{|\boldsymbol{S}_n|}}_{F(\hat{\boldsymbol{\Sigma}})} \tag{6.3}\]
O fator entre colchetes é uma correção de Bartlett que faz o papel de \(n\) e melhora a aproximação em amostras moderadas. Valores grandes indicam que a matriz implicada pelo modelo se afasta demais da observada, e levam à rejeição.
Sob \(H_0\), a estatística segue aproximadamente uma distribuição \(\chi^2\), e o número de graus de liberdade sai de uma contagem. A Equação 6.2 pede que \(p(p+1)/2\) números distintos de \(\boldsymbol{\Sigma}\) sejam reproduzidos por \(\boldsymbol{L}\) e \(\boldsymbol{\Psi}\), que trazem \(p(m+1)\) parâmetros. Descontada a redundância da rotação, sobram
\[ \text{gl} = \frac{1}{2}\left[(p-m)^2 - (p+m)\right] \tag{6.4}\]
graus de liberdade. Quando \(\text{gl} > 0\), o modelo impõe restrições sobre \(\boldsymbol{\Sigma}\) que os dados podem contrariar, e faz sentido testá-lo. Quando \(\text{gl} = 0\), há tantos parâmetros quanto equações e o modelo em geral reproduz \(\boldsymbol{\Sigma}\) exatamente, sem que isso conte como evidência a seu favor. Quando \(\text{gl} < 0\), pedimos fatores demais e o modelo sequer está identificado. Com \(p = 25\) e \(m = 5\), como no Exemplo 6.7, sobram 185 graus de liberdade, e aí o ajuste passa a ser informativo. O exemplo dos gastos está no extremo oposto.
Exemplo 6.4 Ajustando um fator por máxima verossimilhança à matriz de correlações dos gastos familiares, obtemos cargas \((0.8,\ 0.7,\ 0.6)^T\) e \(\hat{\psi} = (0.36,\ 0.51,\ 0.64)^T\), a solução exata do Exemplo 6.1, que o método de componentes principais não alcançava e a fatoração do eixo principal só alcançava depois de iterar. Como \(\hat{\boldsymbol{\Sigma}}\) reproduz \(\boldsymbol{R}\) sem erro, a discrepância \(F(\hat{\boldsymbol{\Sigma}})\) é zero e a estatística do teste também. Isso não conta a favor do modelo. Com \(p = 3\) e \(m = 1\) temos \(\text{gl} = 0\), o ajuste exato já estava garantido pela contagem e o teste não tem o que avaliar.
Esse teste é sensível ao tamanho da amostra. Com \(n\) grande, diferenças irrelevantes entre \(\hat{\boldsymbol{\Sigma}}\) e \(\boldsymbol{S}_n\) produzem estatísticas enormes, e a hipótese acaba rejeitada para todo \(m\) que se tente. Usá-lo como critério único de escolha tende a inflar o número de fatores sem ganho interpretativo. O exemplo do Big Five, adiante, mostra isso acontecendo.
A escolha do método depende das suposições que podemos fazer sobre os dados e das dificuldades encontradas no ajuste. A máxima verossimilhança costuma ser usada quando a normalidade é plausível, pois permite testar o ajuste e tem a propriedade de invariância de escala. Mesmo sem normalidade, minimizar \(F\) continua sendo uma forma razoável de aproximar \(\boldsymbol{S}_n\), mas o teste pode deixar de ser confiável. Quando a otimização não converge ou produz casos de Heywood, a fatoração do eixo principal é uma alternativa que não exige uma distribuição específica para os dados. O método de componentes principais pode ser usado numa primeira exploração, lembrando que tende a superestimar as cargas quando as comunalidades são baixas.
6.3 Escolha do número de fatores
A escolha de \(m\) exige combinar os critérios numéricos com a interpretação dos fatores. Com poucos fatores, algumas correlações importantes podem ficar sem explicação. Com fatores demais, a solução pode se tornar difícil de interpretar e apresentar casos de Heywood. Os critérios disponíveis são quase todos herdados da ACP (Capítulo 4) e devem ser avaliados em conjunto. Os que usam apenas os autovalores de \(\boldsymbol{R}\) podem, inclusive, ser aplicados antes de qualquer estimação.
O critério da variância explicada retém fatores até que a proporção acumulada atinja um patamar considerado suficiente. Em AF esse patamar costuma ser bem mais baixo do que em ACP, porque aqui só a parte comum entra na conta e a variância específica fica de fora por construção. O critério de Kaiser, aplicado à matriz de correlações, retém os fatores com autovalor maior que 1, sob o argumento de que um fator deve ao menos explicar tanto quanto uma variável isolada. Ele é simples e por isso popular, mas tem a tendência conhecida de superestimar \(m\). O gráfico do cotovelo procura visualmente o ponto em que os autovalores passam a decair devagar, e tem o defeito de que cada leitor enxerga o cotovelo num lugar.
A análise paralela é o critério mais confiável do conjunto e deve ser o preferido quando estiver disponível. Em vez de comparar os autovalores com um limiar fixo, ela os compara com a distribuição dos autovalores que se obteria em dados sem nenhuma estrutura, mas com o mesmo \(n\) e o mesmo \(p\). Permuta-se cada coluna da matriz de dados de forma independente, o que destrói as correlações e preserva as distribuições marginais, recalculam-se os autovalores muitas vezes, e retêm-se apenas os fatores cujos autovalores observados superam um percentil alto dessa distribuição nula. O procedimento é descrito com mais detalhe na Seção 4.11.4.
Quando a estimação é por máxima verossimilhança, o teste da Equação 6.3 ainda permite comparar modelos aninhados, com a ressalva sobre amostras grandes já registrada.
Quando os critérios indicam números diferentes de fatores, vale ajustar as soluções candidatas e comparar a interpretação de seus fatores à luz do problema estudado.
Depois de estimar, há ainda um sinal de alerta a observar. Como \(\psi_j\) é uma variância, precisa ser não negativa, e como \(h_j^2\) é uma parcela da variância total, não pode ultrapassá-la. Nada no sistema de equações impõe isso, e soluções que violam essas restrições aparecem com alguma frequência. São os chamados casos de Heywood.
Exemplo 6.5 (Caso de Heywood) Suponha que, para três variáveis padronizadas, a matriz de correlações observada seja
\[ \boldsymbol{R}= \begin{pmatrix} 1.0 & 0.4 & 0.9 \\ 0.4 & 1.0 & 0.7 \\ 0.9 & 0.7 & 1.0 \end{pmatrix} \]
Repetindo a conta do Exemplo 6.1 para a terceira variável,
\[ \ell_3^2 = \frac{(\ell_1\ell_3)(\ell_2\ell_3)}{\ell_1\ell_2} = \frac{0.9 \times 0.7}{0.4} = 1.575 \]
A comunalidade \(h_3^2 = 1.575\) excede a variância total da variável, que é 1, e a variância específica correspondente seria \(\psi_3 = 1 - 1.575 = -0.575\). Não existe modelo de um fator compatível com essas correlações.
Um número inadequado de fatores, tanto por excesso quanto por falta, pode levar a estimativas negativas de variância específica. Em amostras pequenas, a variabilidade amostral também pode produzir casos de Heywood. Quando isso acontece, vale reavaliar o número de fatores e as variáveis incluídas no modelo. Substituir a estimativa negativa por zero não resolve a dificuldade de ajuste que levou a esse resultado.
6.4 Rotação fatorial
A orientação dos fatores não é determinada pelo modelo. Podemos girar os eixos fatoriais e alterar as cargas sem mudar a matriz de covariâncias reproduzida. A rotação usa essa liberdade para procurar uma matriz de cargas mais fácil de interpretar.
Seja \(\boldsymbol{T}\) uma matriz ortogonal \(m \times m\), com \(\boldsymbol{T}^T\boldsymbol{T} = \boldsymbol{I}_m\). Podemos definir novas cargas e novos fatores por
\[ \boldsymbol{L}^* = \boldsymbol{L}\boldsymbol{T}, \qquad \boldsymbol{F}^* = \boldsymbol{T}^T\boldsymbol{F} \]
O produto \(\boldsymbol{L}^*\boldsymbol{F}^* = \boldsymbol{L}\boldsymbol{F}\) permanece o mesmo, assim como a parte comum da matriz de covariâncias,
\[ \boldsymbol{L}^*(\boldsymbol{L}^*)^T = \boldsymbol{L}\boldsymbol{T}\boldsymbol{T}^T\boldsymbol{L}^T = \boldsymbol{L}\boldsymbol{L}^T \]
Os fatores continuam com média zero e \(\operatorname{Cov}\left(\boldsymbol{F}^*\right) = \boldsymbol{I}_m\). As variâncias específicas e as comunalidades também não mudam. Portanto, a rotação ortogonal preserva a matriz de covariâncias reproduzida e todos os resíduos do ajuste.
O que muda é a distribuição das cargas entre os fatores. Procuramos uma estrutura simples, com poucas cargas altas em módulo por variável e as demais próximas de zero. Assim, podemos interpretar cada fator pelo que as variáveis mais associadas a ele têm em comum. Nem todo conjunto de dados admite uma separação clara, e a rotação não garante que cada variável se associe a apenas um fator.
6.4.1 Varimax
A varimax escolhe uma rotação ortogonal que torna as cargas ao quadrado mais diferentes entre si dentro de cada coluna. Se um fator tem cargas parecidas em todas as variáveis, pouco sabemos sobre quais delas o caracterizam. Se tem cargas altas em um grupo e quase nulas nas demais, a interpretação fica mais clara.
Partimos das cargas estimadas \(\hat{\boldsymbol{L}}\). Cada matriz ortogonal \(\boldsymbol{T}\) produz cargas giradas \(\hat{\boldsymbol{L}}^* = \hat{\boldsymbol{L}}\boldsymbol{T}\), com elementos \(\hat{\ell}_{jk}^*\). O critério varimax eleva essas cargas ao quadrado, calcula a variância dos quadrados em cada coluna e soma sobre os fatores,
\[ V = \sum_{k=1}^m \frac{1}{p}\sum_{j=1}^p \left[(\hat{\ell}_{jk}^*)^2 - \frac{1}{p}\sum_{i=1}^p (\hat{\ell}_{ik}^*)^2\right]^2 \tag{6.5}\]
As cargas giradas mudam conforme o giro, e \(V\) muda junto. A varimax procura, entre todas as matrizes ortogonais \(\boldsymbol{T}\), aquela que deixa \(V\) o maior possível. Uma maneira de fazer a busca é girar um par de eixos por vez, mantendo os demais fixos e escolhendo o giro que mais aumenta \(V\). Percorremos os pares de fatores e repetimos o processo até que a melhora no critério seja menor que uma tolerância. Há também algoritmos que atualizam a matriz ortogonal inteira em cada iteração. Como podem existir máximos locais, diferentes orientações iniciais podem ser comparadas.
NotaVarimax e lasso
A busca por cargas pequenas lembra o lasso, que usa uma penalização L1, proporcional à soma dos módulos dos coeficientes, e pode tornar alguns deles exatamente nulos.
A varimax também favorece uma representação com poucas cargas altas, mas faz isso girando os fatores, sem acrescentar penalização à estimação. A matriz de covariâncias reproduzida permanece a mesma, e as cargas pequenas não precisam ser exatamente nulas.
Exemplo 6.6 (Testes de habilidades) Considere seis testes padronizados. Os testes \(X_1\), \(X_2\) e \(X_3\) avaliam vocabulário, compreensão de texto e fluência verbal; \(X_4\), \(X_5\) e \(X_6\) avaliam cálculo, álgebra e raciocínio numérico. Para acompanhar a análise, usaremos a matriz de correlações hipotética
\[ \boldsymbol{R}= \begin{pmatrix} 1.00 & 0.73 & 0.64 & 0.29 & 0.18 & 0.23 \\ 0.73 & 1.00 & 0.59 & 0.36 & 0.24 & 0.28 \\ 0.64 & 0.59 & 1.00 & 0.20 & 0.11 & 0.16 \\ 0.29 & 0.36 & 0.20 & 1.00 & 0.63 & 0.55 \\ 0.18 & 0.24 & 0.11 & 0.63 & 1.00 & 0.48 \\ 0.23 & 0.28 & 0.16 & 0.55 & 0.48 & 1.00 \end{pmatrix} \]
Como as variáveis estão padronizadas, essa é também sua matriz de covariâncias. As correlações são maiores dentro de cada grupo de três testes do que entre os grupos, o que sugere experimentar dois fatores. Primeiro, vamos estimar as cargas pelo método de componentes principais da Definição 6.2.
Código
import numpy as np
import pandas as pd

R_sim = np.array([
    [1.00, 0.73, 0.64, 0.29, 0.18, 0.23],
    [0.73, 1.00, 0.59, 0.36, 0.24, 0.28],
    [0.64, 0.59, 1.00, 0.20, 0.11, 0.16],
    [0.29, 0.36, 0.20, 1.00, 0.63, 0.55],
    [0.18, 0.24, 0.11, 0.63, 1.00, 0.48],
    [0.23, 0.28, 0.16, 0.55, 0.48, 1.00],
])

autovalores_sim, autovetores_sim = np.linalg.eigh(R_sim)
ordem_sim = np.argsort(autovalores_sim)[::-1]
autovalores_sim = autovalores_sim[ordem_sim]
autovetores_sim = autovetores_sim[:, ordem_sim]
L_nao_rot = autovetores_sim[:, :2] * np.sqrt(autovalores_sim[:2])

# Os sinais dos autovetores são convencionais; fixamos uma orientação.
if L_nao_rot[0, 0] < 0:
    L_nao_rot[:, 0] *= -1
if L_nao_rot[0, 1] > 0:
    L_nao_rot[:, 1] *= -1

h2_sim = (L_nao_rot ** 2).sum(axis=1)
psi_sim = 1 - h2_sim
Os dois maiores autovalores são aproximadamente \(2.912\) e \(1.530\). Multiplicando os autovetores correspondentes pelas raízes desses valores, obtemos
\[ \hat{\boldsymbol{L}} \approx \begin{pmatrix} 0.765 & -0.480 \\ 0.797 & -0.382 \\ 0.663 & -0.539 \\ 0.712 & 0.505 \\ 0.600 & 0.602 \\ 0.620 & 0.497 \end{pmatrix} \]
As somas dos quadrados das linhas dão as comunalidades, e o que falta para 1 fica nas variâncias específicas,
\[ \hat{\boldsymbol{\Psi}} \approx \operatorname{diag}\left(0.184,\ 0.219,\ 0.270,\ 0.238,\ 0.277,\ 0.369\right) \]
O primeiro fator tem cargas positivas em todos os testes. O segundo tem cargas negativas nos testes verbais e positivas nos numéricos. Vamos procurar uma orientação que separe melhor esses dois grupos.
Como há apenas dois fatores, basta girar o par de eixos por um ângulo \(\theta\). A matriz desse giro é
\[ \boldsymbol{T}(\theta) = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \cos\theta \end{pmatrix} \]
Buscamos o ângulo \(\theta\) para o qual as cargas giradas \(\hat{\boldsymbol{L}}\boldsymbol{T}(\theta)\) dão o maior valor de \(V\). O código abaixo aplica a varimax, sem normalizar as linhas, usando exatamente o critério da Equação 6.5.
Código
from factor_analyzer import Rotator

rotacionador = Rotator(method="varimax", normalize=False, tol=1e-10)
L_rot = rotacionador.fit_transform(L_nao_rot)
T_var = rotacionador.rotation_

def criterio_varimax(cargas):
    return (cargas ** 2).var(axis=0, ddof=0).sum()

V_antes = criterio_varimax(L_nao_rot)
V_depois = criterio_varimax(L_rot)

tabela_varimax = pd.DataFrame(
    np.column_stack([L_nao_rot, L_rot, h2_sim, psi_sim]),
    index=[f"X{j}" for j in range(1, 7)],
    columns=["F1 inicial", "F2 inicial", "F1 varimax", "F2 varimax", "$h^2$", r"$\psi$"],
)
tabela_varimax.index.name = "Teste"
print(tabela_varimax.to_markdown(floatfmt=".3f"))| Teste | F1 inicial | F2 inicial | F1 varimax | F2 varimax | \(h^2\) | \(\psi\) |
|---|---|---|---|---|---|---|
| X1 | 0.765 | -0.480 | 0.893 | 0.137 | 0.816 | 0.184 |
| X2 | 0.797 | -0.382 | 0.853 | 0.232 | 0.781 | 0.219 |
| X3 | 0.663 | -0.539 | 0.854 | 0.026 | 0.730 | 0.270 |
| X4 | 0.712 | 0.505 | 0.208 | 0.848 | 0.762 | 0.238 |
| X5 | 0.600 | 0.602 | 0.061 | 0.848 | 0.723 | 0.277 |
| X6 | 0.620 | 0.497 | 0.144 | 0.781 | 0.631 | 0.369 |
Depois da rotação, o primeiro fator reúne os testes verbais, com cargas entre 0.85 e 0.89, e o segundo reúne os numéricos, com cargas entre 0.78 e 0.85. As cargas nos outros fatores ficam abaixo de 0.24 em módulo. Podemos, então, interpretar os fatores como habilidade verbal e habilidade matemática.
A matriz encontrada é, aproximadamente,
\[ \boldsymbol{T} = \begin{pmatrix} 0.757 & 0.654 \\ -0.654 & 0.757 \end{pmatrix} \]
Ela corresponde a \(\theta \approx -40.8^\circ\). O critério sobe de 0.0144 para 0.2432. A Figura 6.3 mostra como esse giro aproxima os eixos dos dois grupos de testes.
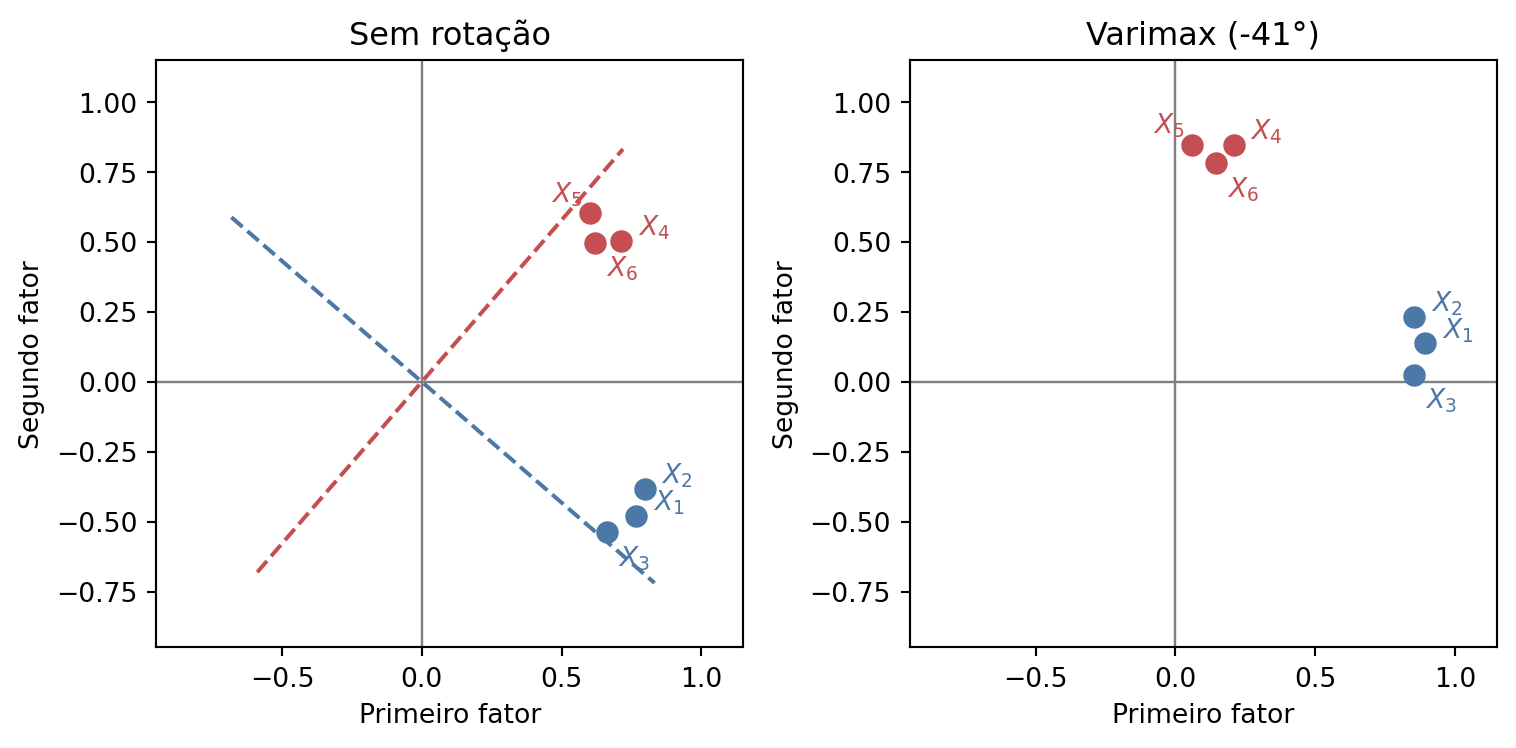
Cada ponto representa um teste, e suas coordenadas são as cargas nos dois fatores. A rotação preserva as distâncias entre os pontos e de cada ponto à origem. O quadrado desta última distância é justamente a comunalidade.
6.4.2 Outras rotações
Entre as rotações ortogonais, a quartimax maximiza \(\sum_{j,k}(\hat{\ell}_{jk}^*)^4\). Como a soma dos quadrados de cada linha é fixa, o critério favorece concentrar as cargas de cada variável em poucos fatores. Pode, por isso, produzir um fator com cargas altas em muitas variáveis, um fator geral. A equimax combina os critérios de simplificação das linhas e das colunas, ponderando-os pelo número de variáveis e de fatores.
Também podemos permitir que os fatores sejam correlacionados. No exemplo dos testes, separar habilidade verbal de habilidade matemática não implica que elas sejam não correlacionadas. Numa rotação oblíqua, usamos uma matriz invertível \(\boldsymbol{Q}\) e definimos
\[ \boldsymbol{L}^* = \boldsymbol{L}\boldsymbol{Q}, \qquad \boldsymbol{F}^* = \boldsymbol{Q}^{-1}\boldsymbol{F}, \qquad \boldsymbol{\Phi} = \operatorname{Cov}\left(\boldsymbol{F}^*\right) = \boldsymbol{Q}^{-1}(\boldsymbol{Q}^{-1})^T \]
As colunas de \(\boldsymbol{Q}\) são reescaladas para que os fatores tenham variância 1, tornando \(\boldsymbol{\Phi}\) uma matriz de correlações. A estrutura de covariâncias continua preservada, agora na forma
\[ \boldsymbol{\Sigma}= \boldsymbol{L}^*\boldsymbol{\Phi}(\boldsymbol{L}^*)^T + \boldsymbol{\Psi}, \qquad \boldsymbol{L}^*\boldsymbol{\Phi}(\boldsymbol{L}^*)^T = \boldsymbol{L}\boldsymbol{L}^T \tag{6.6}\]
Assim, as comunalidades permanecem as mesmas, mas passam a ser os elementos diagonais de \(\boldsymbol{L}^*\boldsymbol{\Phi}(\boldsymbol{L}^*)^T\), e não apenas as somas dos quadrados das linhas de \(\boldsymbol{L}^*\).
A promax parte de cargas varimax \(b_{jk}\) e constrói um alvo \(u_{jk} = b_{jk}|b_{jk}|^{r-1}\), geralmente com \(r = 4\). Isso equivale a elevar o módulo de cada carga à potência \(r\), preservando o sinal, e acentua a diferença relativa entre cargas grandes e pequenas. Em seguida, ajusta uma transformação oblíqua ao alvo por mínimos quadrados e reescala os fatores para variância 1. Aplicaremos esse procedimento no Exemplo 6.7.
A oblimin direta otimiza um critério sobre as cargas, sem construir um alvo. Seu parâmetro modifica o critério de simplicidade, sem fixar ou limitar diretamente as correlações entre fatores. Na versão quartimin, esse parâmetro é zero e minimizamos \(\sum_j\sum_{k<k'}(\ell_{jk}^*)^2(\ell_{jk'}^*)^2\), que penaliza cargas simultaneamente altas em dois fatores na mesma variável.
Na solução oblíqua, precisamos distinguir a matriz de padrões, \(\boldsymbol{L}^*\), da matriz de estrutura, \(\boldsymbol{L}^*\boldsymbol{\Phi}\). A primeira contém os coeficientes da regressão linear das variáveis nos fatores, considerando-os em conjunto. A segunda contém as covariâncias \(\operatorname{Cov}\left(\boldsymbol{x},\boldsymbol{F}^*\right)\); quando as variáveis observadas também estão padronizadas, seus elementos são correlações. Para interpretar os fatores, olhamos principalmente a matriz de padrões. Uma correlação alta na matriz de estrutura pode vir da correlação com outro fator, mesmo que a carga no fator em questão seja pequena. As duas matrizes coincidem quando \(\boldsymbol{\Phi} = \boldsymbol{I}_m\).
A escolha entre rotação ortogonal e oblíqua deve acompanhar a interpretação dos fatores. Se faz sentido admitir associação entre eles, uma rotação oblíqua permite examiná-la por meio de \(\boldsymbol{\Phi}\). Um ajuste idêntico nas duas soluções é esperado e não serve para decidir entre elas.
6.5 Escores fatoriais
Com as cargas estimadas, falta situar cada indivíduo nos fatores, tal como fizemos com os escores da ACP. Esses valores servem para representar as observações graficamente e para alimentar análises posteriores, usando os fatores no lugar das variáveis originais.
Só que os escores da ACP eram \(\boldsymbol{X}\boldsymbol{E}\), uma transformação determinística dos dados, enquanto \(\boldsymbol{F}\) é uma variável aleatória que ninguém viu e que não se escreve como função das variáveis observadas. O melhor que podemos fazer é predizê-la, e métodos diferentes de predição dão respostas diferentes.
O método da regressão, também chamado de método de Thomson, trata o problema como a predição de \(\boldsymbol{F}\) a partir de \(\boldsymbol{x}\) que minimiza o erro quadrático médio. Sob o modelo fatorial, \(\operatorname{Cov}\left(\boldsymbol{F}, \boldsymbol{x}\right) = \boldsymbol{L}^T\) e \(\operatorname{Cov}\left(\boldsymbol{x}\right) = \boldsymbol{\Sigma}\), de modo que a regressão linear de \(\boldsymbol{F}\) em \(\boldsymbol{x}\) tem coeficientes \(\boldsymbol{L}^T\boldsymbol{\Sigma}^{-1}\) e
\[ \hat{\boldsymbol{f}}_i = \hat{\boldsymbol{L}}^T\left(\hat{\boldsymbol{L}}\hat{\boldsymbol{L}}^T + \hat{\boldsymbol{\Psi}}\right)^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}}) \tag{6.7}\]
Entre as predições lineares, esses escores têm o menor erro quadrático médio. Eles, porém, tendem a ficar mais próximos de zero do que os valores dos fatores que procuram predizer. Esse efeito é chamado de encolhimento e se reflete na variância dos escores, que é menor que 1, a variância de cada fator.
O método de Bartlett trata \(\boldsymbol{F}\) como um parâmetro fixo a ser estimado e aplica mínimos quadrados ponderados, usando \(\boldsymbol{\Psi}^{-1}\) como peso, já que variáveis com variância específica grande são medidas mais ruidosas do fator e devem pesar menos. O resultado é
\[ \hat{\boldsymbol{f}}_i = \left(\hat{\boldsymbol{L}}^T\hat{\boldsymbol{\Psi}}^{-1}\hat{\boldsymbol{L}}\right)^{-1}\hat{\boldsymbol{L}}^T\hat{\boldsymbol{\Psi}}^{-1}(\boldsymbol{x}_i - \bar{\boldsymbol{x}}) \tag{6.8}\]
Esses escores são não viesados, no sentido de que \(\operatorname{E}\left[\hat{\boldsymbol{f}} \mid \boldsymbol{F}\right] = \boldsymbol{F}\), ao custo de uma variância maior que a do método da regressão. A escolha entre os dois é a escolha usual entre viés e variância. Quando os escores vão ser correlacionados com outras variáveis, o encolhimento do método da regressão pode distorcer as conclusões, e os escores de Bartlett costumam ser preferíveis. Para representação gráfica, a diferença raramente importa.
Quando a solução é oblíqua, ambas as fórmulas se ajustam para acomodar \(\boldsymbol{\Phi}\); no caso da regressão, por exemplo, os coeficientes passam a ser \(\boldsymbol{\Phi}\boldsymbol{L}^T\boldsymbol{\Sigma}^{-1}\).
NotaIndeterminação dos escores
Mesmo que \(\boldsymbol{L}\) e \(\boldsymbol{\Psi}\) fossem conhecidos exatamente, e com \(n\) infinito, os escores fatoriais continuariam indeterminados. Existe toda uma família de vetores aleatórios \(\boldsymbol{F}\) compatíveis com o modelo e com os dados observados, e nada nas observações permite escolher entre eles. Esse resultado é conhecido como indeterminação dos escores fatoriais.
A gravidade do problema depende das comunalidades. Quando elas são altas, os candidatos ficam próximos uns dos outros e a indeterminação é inofensiva; quando são baixas, dois conjuntos de escores igualmente válidos podem até correlacionar mal entre si.
6.6 Exemplo prático
Exemplo 6.7 (Traços de personalidade) O conjunto bfi, do pacote R psych, reúne respostas de 2800 pessoas a 25 itens de personalidade, medidos em escala de 1 a 5. Os itens foram construídos para medir cinco traços, o chamado Big Five, com cinco itens cada: amabilidade (A), conscienciosidade (C), extroversão (E), neuroticismo (N) e abertura à experiência (O). Queremos saber se a análise fatorial, olhando apenas para as correlações entre os itens e sem saber nada sobre essa divisão, consegue recuperá-la.
Código
import pandas as pd
from factor_analyzer import FactorAnalyzer

bfi = pd.read_csv("dados/bfi.csv")
itens = [c for c in bfi.columns if c[0] in "ACENO" and c[1:].isdigit()]

# Itens de redação invertida: discordar deles indica mais do traço, não menos.
invertidos = ["A1", "C4", "C5", "E1", "E2", "O2", "O5"]

dados = bfi[itens].dropna().copy()
dados[invertidos] = 6 - dados[invertidos]

n_obs, p_itens = dados.shape
Alguns itens são redigidos ao contrário dos demais para desencorajar respostas automáticas. O item A1, por exemplo, afirma indiferença aos sentimentos alheios, de modo que discordar dele indica mais amabilidade. Sem recodificar, esses itens aparecem com cargas negativas no fator do seu próprio bloco, o que não está errado, mas atrapalha a leitura, e mais adiante inverteria também o sinal das correlações entre os fatores. Subtrair de 6 alinha todos os itens no mesmo sentido.
Restaram 2436 respostas completas para 25 itens, que usaremos para ajustar o modelo.
Quantos fatores extrair? O critério de Kaiser e a análise paralela não concordam.
Código
R_bfi = np.corrcoef(dados.to_numpy(), rowvar=False)
autovalores_bfi = np.linalg.eigvalsh(R_bfi)[::-1]

# Distribuição nula: permutar cada coluna destrói as correlações
# e preserva as distribuições marginais.
rng = np.random.default_rng(2026)
Z_bfi = dados.to_numpy()
nulos = np.empty((200, p_itens))
for b in range(200):
    Z_perm = np.column_stack(
        [rng.permutation(Z_bfi[:, j]) for j in range(p_itens)]
    )
    nulos[b] = np.linalg.eigvalsh(np.corrcoef(Z_perm, rowvar=False))[::-1]
percentil95 = np.quantile(nulos, 0.95, axis=0)

n_kaiser = int((autovalores_bfi > 1).sum())
n_paralela = int((autovalores_bfi > percentil95).sum())

eixo_fatores = np.arange(1, p_itens + 1)
fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(eixo_fatores, autovalores_bfi, "o-", color=cor_obs, linewidth=2,
        markersize=5, label="Autovalores observados")
ax.plot(eixo_fatores, percentil95, "o--", color=cor_fator, linewidth=1.6,
        markersize=4, label="Percentil 95 sob independência")
ax.axhline(1, color="gray", linestyle=":", linewidth=1.3,
           label="Critério de Kaiser")
ax.set(xlabel="Fator", ylabel="Autovalor", xticks=eixo_fatores[::2])
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()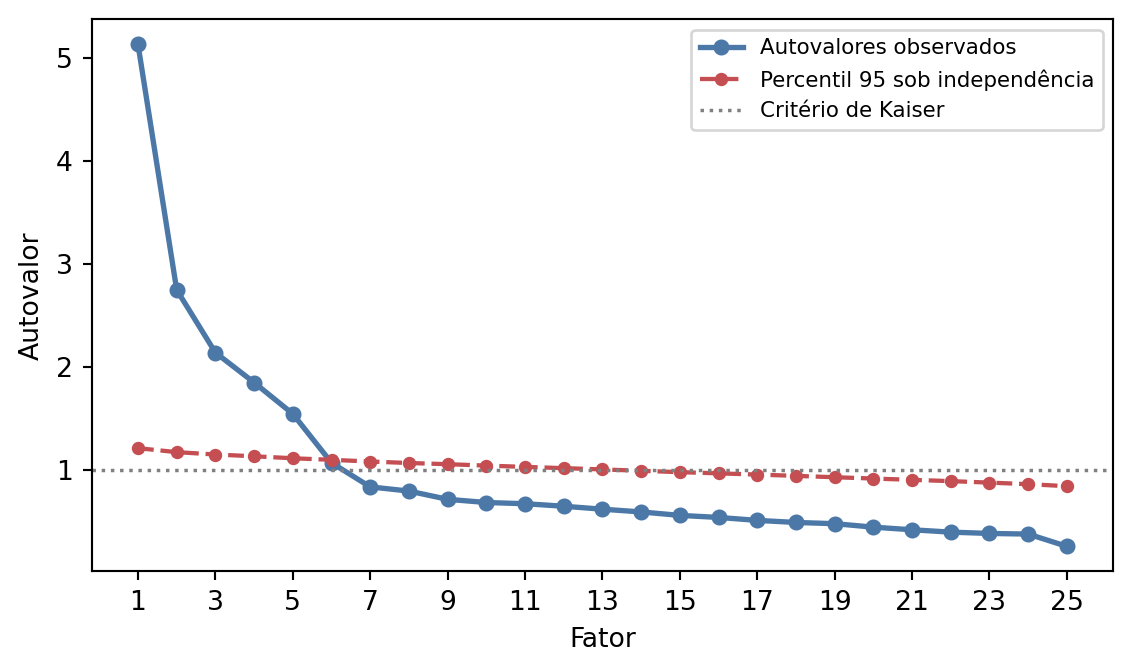
O critério de Kaiser retém 6 fatores e a análise paralela retém 5. A discrepância é a esperada, com o critério de Kaiser pecando pelo excesso. O sexto autovalor vale 1.07, mal ultrapassando 1, enquanto o percentil 95 sob independência naquela posição é 1.10. Ficamos com cinco fatores, decisão que a análise paralela sustenta e que coincide com a estrutura teórica dos itens.
Ajustamos então o modelo por máxima verossimilhança, com rotação varimax.
Código
nomes_fatores = ["N", "E", "C", "A", "O"]

af = FactorAnalyzer(n_factors=5, rotation="varimax", method="ml")
af.fit(dados)

cargas = pd.DataFrame(af.loadings_, index=itens, columns=nomes_fatores)
comunalidades = pd.Series(af.get_communalities(), index=itens)

tabela = cargas.round(2).where(cargas.abs() >= 0.3, "")
tabela["Comunalidade"] = comunalidades.round(2)
tabela| N | E | C | A | O | Comunalidade | |
|---|---|---|---|---|---|---|
| A1 | 0.39 | 0.17 | ||||
| A2 | 0.6 | 0.42 | ||||
| A3 | 0.66 | 0.53 | ||||
| A4 | 0.45 | 0.31 | ||||
| A5 | 0.35 | 0.58 | 0.49 | |||
| C1 | 0.53 | 0.34 | ||||
| C2 | 0.62 | 0.43 | ||||
| C3 | 0.55 | 0.32 | ||||
| C4 | 0.65 | 0.49 | ||||
| C5 | 0.57 | 0.44 | ||||
| E1 | 0.59 | 0.37 | ||||
| E2 | 0.67 | 0.55 | ||||
| E3 | 0.49 | 0.31 | 0.31 | 0.44 | ||
| E4 | 0.61 | 0.36 | 0.53 | |||
| E5 | 0.49 | 0.31 | 0.41 | |||
| N1 | 0.82 | 0.73 | ||||
| N2 | 0.79 | 0.66 | ||||
| N3 | 0.71 | 0.52 | ||||
| N4 | 0.56 | -0.37 | 0.49 | |||
| N5 | 0.52 | 0.34 | ||||
| O1 | 0.52 | 0.33 | ||||
| O2 | 0.45 | 0.26 | ||||
| O3 | 0.61 | 0.48 | ||||
| O4 | 0.37 | 0.25 | ||||
| O5 | 0.51 | 0.27 |
A ordem em que os fatores saem da estimação é arbitrária, e os nomes na tabela foram atribuídos depois de olhar para as cargas. Cada bloco de cinco itens se concentra num fator diferente, e a análise recuperou a divisão teórica sem ter acesso a ela.
Alguns itens se ajustam menos à estrutura de cinco fatores. O item A1 tem a menor comunalidade do conjunto, 0.17, de modo que quase 83% da sua variância não é explicada pelos fatores estimados. Essa comunalidade baixa merece atenção, mas, sozinha, não permite concluir que o item mede mal a amabilidade. O item E3 tem cargas em extroversão, amabilidade e abertura, enquanto E5 tem cargas em extroversão e conscienciosidade. Já N4 tem carga substancial em neuroticismo e carga negativa em extroversão, o que combina com o conteúdo do item, que trata de desânimo e abatimento. As comunalidades, em geral entre 0.3 e 0.5, são modestas, o que é normal em itens isolados de questionário e nos lembra que boa parte da variância de cada resposta é específica dela.
Como o ajuste foi por máxima verossimilhança, podemos também aplicar o teste da Equação 6.3. Vale conferir o que ele diz para cinco fatores e para alguns valores maiores de \(m\).
Código
from scipy import stats

def teste_rv(m):
    ajuste = FactorAnalyzer(n_factors=m, rotation=None, method="ml")
    ajuste.fit(dados)
    L_m = ajuste.loadings_
    Sigma_m = L_m @ L_m.T + np.diag(ajuste.get_uniquenesses())
    F_m = np.linalg.slogdet(Sigma_m)[1] - np.linalg.slogdet(R_bfi)[1]
    gl = ((p_itens - m) ** 2 - (p_itens + m)) / 2
    qui2 = (n_obs - 1 - (2 * p_itens + 4 * m + 5) / 6) * F_m
    return gl, qui2, stats.chi2.sf(qui2, gl)

testes_bfi = pd.DataFrame(
    [teste_rv(m) for m in range(5, 12)],
    index=pd.Index(range(5, 12), name="m"),
    columns=["gl", "qui-quadrado", "p-valor"],
)
testes_bfi.assign(
    gl=testes_bfi["gl"].astype(int),
    **{"qui-quadrado": testes_bfi["qui-quadrado"].round(1)},
    **{"p-valor": testes_bfi["p-valor"].map("{:.1e}".format)},
)| gl | qui-quadrado | p-valor | |
|---|---|---|---|
| m | |||
| 5 | 185 | 1490.6 | 1.2e-202 |
| 6 | 165 | 896.7 | 5.7e-101 |
| 7 | 146 | 619.2 | 1.6e-59 |
| 8 | 128 | 438.2 | 1.5e-35 |
| 9 | 111 | 316.1 | 1.4e-21 |
| 10 | 95 | 224.8 | 1.6e-12 |
| 11 | 80 | 147.8 | 6.2e-06 |
Com cinco fatores, a estatística vale 1491 para 185 graus de liberdade, e o teste rejeita a hipótese de ajuste. Se usássemos apenas esse resultado para decidir, aumentaríamos o número de fatores. Mas o teste continua rejeitando com seis, sete e até onze fatores, bem além do que a análise paralela sugere, enquanto a solução com cinco recuperou a estrutura teórica dos itens. Esse resultado ilustra a sensibilidade do teste ao tamanho da amostra. Com mais de dois mil respondentes, mesmo discrepâncias pequenas entre \(\boldsymbol{R}\) e \(\hat{\boldsymbol{\Sigma}}\) podem levar à rejeição.
Os cinco traços serão mesmo não correlacionados, como a rotação varimax impôs? O promax responde a isso, partindo da própria solução varimax. Vamos implementá-lo à mão, tanto porque o procedimento é curto quanto porque assim fica explícito de onde vêm a matriz de padrões e a matriz de correlações entre fatores.
Código
Lambda = af.loadings_
psi = af.get_uniquenesses()

# Elevar o módulo das cargas a k reduz proporcionalmente mais as pequenas.
k_promax = 4
alvo = np.sign(Lambda) * np.abs(Lambda) ** k_promax

# Transformação de mínimos quadrados que leva a solução varimax ao alvo.
Q = np.linalg.solve(Lambda.T @ Lambda, Lambda.T @ alvo)
# Reescala as colunas de Q para que Phi tenha diagonal unitária.
Q = Q * np.sqrt(np.diag(np.linalg.inv(Q.T @ Q)))

padroes = Lambda @ Q
Phi = np.linalg.inv(Q.T @ Q)
estrutura = padroes @ Phi

pd.DataFrame(Phi, index=nomes_fatores, columns=nomes_fatores).round(2)| N | E | C | A | O | |
|---|---|---|---|---|---|
| N | 1.00 | -0.37 | -0.25 | 0.06 | 0.02 |
| E | -0.37 | 1.00 | 0.37 | 0.25 | 0.14 |
| C | -0.25 | 0.37 | 1.00 | 0.22 | 0.24 |
| A | 0.06 | 0.25 | 0.22 | 1.00 | 0.21 |
| O | 0.02 | 0.14 | 0.24 | 0.21 | 1.00 |
A transformação oblíqua não altera o ajuste. A raiz do erro quadrático médio dos resíduos fora da diagonal é 0.0286 para a solução oblíqua e exatamente a mesma para a varimax, porque a matriz de padrões \(\boldsymbol{L}_{\text{pro}}\) e as cargas varimax \(\boldsymbol{L}_{\text{var}}\) satisfazem \(\boldsymbol{L}_{\text{pro}}\boldsymbol{\Phi}\boldsymbol{L}_{\text{pro}}^T = \boldsymbol{L}_{\text{var}}\boldsymbol{L}_{\text{var}}^T\).
As correlações entre fatores não são desprezíveis e vão na direção que a literatura de personalidade descreve. Neuroticismo correlaciona-se negativamente com extroversão (-0.37) e com conscienciosidade (-0.25), enquanto extroversão, conscienciosidade, amabilidade e abertura formam um bloco de correlações positivas moderadas. A suposição de ortogonalidade, portanto, era uma simplificação, ainda que não das mais graves.
Nos números, a distinção entre as duas matrizes da solução oblíqua fica visível.
Código
selecao = ["A3", "C4", "E2", "N4"]
comparacao = pd.concat(
    {
        "Padrão": pd.DataFrame(padroes, index=itens, columns=nomes_fatores).loc[selecao],
        "Estrutura": pd.DataFrame(estrutura, index=itens, columns=nomes_fatores).loc[selecao],
    },
    axis=1,
)
comparacao.round(2)| Padrão | Estrutura | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| N | E | C | A | O | N | E | C | A | O | |
| A3 | -0.03 | 0.18 | 0.00 | 0.66 | 0.02 | -0.06 | 0.36 | 0.22 | 0.71 | 0.18 |
| C4 | -0.10 | -0.02 | 0.68 | -0.06 | 0.01 | -0.27 | 0.25 | 0.69 | 0.08 | 0.16 |
| E2 | -0.03 | 0.71 | -0.02 | 0.06 | 0.05 | -0.28 | 0.73 | 0.27 | 0.24 | 0.15 |
| N4 | 0.40 | -0.39 | -0.13 | 0.09 | 0.09 | 0.59 | -0.55 | -0.33 | 0.01 | 0.04 |
Veja o item C4, sobre fazer as coisas pela metade. Seu coeficiente de padrão em neuroticismo é pequeno, mas sua correlação com o fator, na matriz de estrutura, é bem maior em módulo. O item mede conscienciosidade, e esse fator anda junto com neuroticismo. É por esse caminho indireto que o item aparece associado a neuroticismo. Ler a matriz de estrutura como se fossem cargas levaria a atribuir ao item um conteúdo que ele não tem, e por isso os fatores são nomeados pela matriz de padrões.
6.7 Exercícios
Exercício 6.1 Considere o modelo fatorial ortogonal \(\boldsymbol{x}- \boldsymbol{\mu}= \boldsymbol{L}\boldsymbol{F} + \boldsymbol{\epsilon}\), sob as suposições da Definição 6.1.
a) Mostre que \(\operatorname{Cov}\left(\boldsymbol{x}\right) = \boldsymbol{L}\boldsymbol{L}^T + \boldsymbol{\Psi}\).
b) Mostre que \(\operatorname{Cov}\left(X_j, F_k\right) = \ell_{jk}\), isto é, que a carga é a covariância entre a variável e o fator.
c) Suponha agora que \(\boldsymbol{\Psi}\) não seja diagonal, mas uma matriz de covariâncias qualquer. Que restrições o modelo ainda impõe às covariâncias observadas? O que isso implica para sua interpretação?
Exercício 6.2 Um modelo com \(m = 2\) fatores foi ajustado a quatro variáveis padronizadas, produzindo as cargas
\[ \hat{\boldsymbol{L}} = \begin{pmatrix} 0.8 & 0.2 \\ 0.7 & -0.3 \\ 0.3 & 0.8 \\ 0.4 & 0.6 \end{pmatrix} \]
a) Calcule as comunalidades e as variâncias específicas das quatro variáveis.
b) Calcule a correlação entre \(X_1\) e \(X_3\) implicada pelo modelo, e a correlação entre \(X_3\) e \(X_4\).
c) Que proporção da variância total das quatro variáveis é explicada por cada fator?
Exercício 6.3 Seja \(\boldsymbol{T}\) a matriz de rotação no plano,
\[ \boldsymbol{T} = \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \phantom{-}\cos\theta \end{pmatrix} \]
a) Verifique que \(\boldsymbol{T}\) é ortogonal e que, para qualquer \(\theta\), as cargas rotacionadas \(\hat{\boldsymbol{L}}^* = \hat{\boldsymbol{L}}\boldsymbol{T}\) produzem a mesma matriz \(\hat{\boldsymbol{L}}^*(\hat{\boldsymbol{L}}^*)^T\).
b) Mostre que as comunalidades são invariantes à rotação.
c) Aplique a rotação com \(\theta = 30°\) às cargas do Exercício 6.2 e verifique numericamente os dois itens anteriores.
d) Se a rotação não altera nem o ajuste nem as comunalidades, em que sentido uma solução rotacionada é melhor que outra?
Exercício 6.4 Três variáveis padronizadas têm matriz de correlações
\[ \boldsymbol{R}= \begin{pmatrix} 1.0 & 0.8 & 0.3 \\ 0.8 & 1.0 & 0.4 \\ 0.3 & 0.4 & 1.0 \end{pmatrix} \]
a) Resolva o sistema de um fator e obtenha as três cargas.
b) Calcule as comunalidades e as variâncias específicas. A solução é admissível?
c) Use a Equação 6.4 para determinar os graus de liberdade do modelo. O que esse número diz sobre a possibilidade de testar o ajuste?
Exercício 6.5 Considere um modelo de um fator com \(p = 3\) variáveis padronizadas, cargas \(\boldsymbol{L} = (0.9,\ 0.6,\ 0.3)^T\) e as variâncias específicas correspondentes.
a) Escreva os coeficientes do escore de Bartlett dado pela Equação 6.8. Qual variável recebe o maior peso, e por quê?
b) Compare os coeficientes do escore de regressão da Equação 6.7 com os de Bartlett. Os dois métodos atribuem os mesmos pesos relativos às variáveis? E produzem escores na mesma escala?
c) Explique por que os escores de regressão têm variância menor que 1, enquanto os fatores verdadeiros têm variância 1.
Exercício 6.6 Uma equipe de inteligência de mercado aplicou um questionário a 300 consumidores sobre a percepção de uma marca de relógios inteligentes. Os seis itens, medidos de 1 a 7, foram os seguintes:
- \(X_1\): as medições de batimentos cardíacos são precisas
- \(X_2\): o GPS integrado registra minhas rotas sem falhas
- \(X_3\): o design é moderno e elegante
- \(X_4\): as opções de pulseira são esteticamente atraentes
- \(X_5\): o relógio resiste a quedas e ao uso intenso em treinos
- \(X_6\): a bateria dura o tempo prometido pelo fabricante
A matriz de correlações amostral foi
\[ \boldsymbol{R}= \begin{pmatrix} 1.00 & 0.72 & 0.15 & 0.10 & 0.65 & 0.60 \\ 0.72 & 1.00 & 0.12 & 0.08 & 0.70 & 0.62 \\ 0.15 & 0.12 & 1.00 & 0.78 & 0.10 & 0.14 \\ 0.10 & 0.08 & 0.78 & 1.00 & 0.05 & 0.11 \\ 0.65 & 0.70 & 0.10 & 0.05 & 1.00 & 0.58 \\ 0.60 & 0.62 & 0.14 & 0.11 & 0.58 & 1.00 \end{pmatrix} \]
a) Identifique a estrutura de blocos na matriz. Quantos fatores você espera encontrar, e como os interpretaria?
b) A extração por componentes principais com \(m = 2\) produziu \(\hat{\lambda}_1 = 3.01\) e \(\hat{\lambda}_2 = 1.71\). Que proporção da variância total os dois fatores explicam?
c) Quantos graus de liberdade tem esse modelo? Seria possível testar seu ajuste?
d) O que a rotação varimax faria com essa solução? Você esperaria uma mudança grande nas cargas?
Exercício 6.7 (Composição química de vidros romanos) O conjunto dados/RBGlass1.csv reúne medidas de composição química de fragmentos de vidro romano. Conduza uma análise fatorial completa e justifique a padronização das variáveis, o número de fatores, o método de estimação e o tipo de rotação. Se quiser complementar a análise com diagnósticos de adequação, consulte a Seção 6.8.1. Compare a solução obtida com uma ACP dos mesmos dados e discuta em que as duas diferem, tanto nos resultados quanto naquilo que cada uma se propõe a responder.
6.8 Tópicos avançados
6.8.1 Adequação dos dados
Na análise fatorial, procuramos explicar as correlações entre as variáveis por meio de fatores comuns. Se essas correlações forem muito pequenas, pode ser difícil encontrar fatores que expliquem uma parcela relevante da variância das variáveis. Antes de ajustar o modelo, podemos usar o teste de Bartlett e o índice KMO para avaliar se os dados são adequados à análise.
O teste de esfericidade de Bartlett avalia a hipótese \(H_0: \boldsymbol{\rho}= \boldsymbol{I}_p\), ou seja, de que todas as correlações entre variáveis distintas são nulas na população. O teste usa o determinante da matriz de correlações amostral, que tende a ficar próximo de 1 quando as correlações são pequenas e diminui quando há maior dependência linear entre as variáveis. A estatística do teste é dada por
\[ \chi^2 = -\left[(n-1) - \frac{2p+5}{6}\right]\ln|\boldsymbol{R}| \]
Sob \(H_0\) e supondo normalidade multivariada, essa estatística segue aproximadamente uma distribuição \(\chi^2\) com \(p(p-1)/2\) graus de liberdade. Valores elevados levam à rejeição da hipótese nula. Mas rejeitar essa hipótese não basta para concluir que a análise fatorial é adequada. Em amostras grandes, o teste pode detectar correlações pequenas, mesmo que elas sejam pouco úteis para o modelo fatorial.
A medida de Kaiser-Meyer-Olkin (KMO) compara as correlações simples com as correlações parciais. A correlação parcial mede a associação entre duas variáveis depois de descontar a relação linear de cada uma com as demais. Quando a correlação continua alta após esse ajuste, a associação entre as duas é pouco explicada pelas outras variáveis. Para a análise fatorial, esperamos que as correlações parciais sejam pequenas em relação às simples, o que sugere que as associações podem ser explicadas por fatores comuns. O KMO é calculado por
\[ \operatorname{KMO}= \frac{\sum_{j \neq j'} r_{jj'}^2}{\sum_{j \neq j'} r_{jj'}^2 + \sum_{j \neq j'} a_{jj'}^2} \]
em que \(r_{jj'}\) é a correlação simples e \(a_{jj'}\) é a correlação parcial entre \(X_j\) e \(X_{j'}\), ajustada pelas demais variáveis. O índice varia entre 0 e 1. Quanto menores forem as correlações parciais em relação às simples, mais próximo de 1 será o KMO e mais favorável será a indicação para a análise fatorial.
Como orientação prática, valores acima de 0.8 indicam boa adequação, e valores acima de 0.6 costumam ser aceitáveis. Abaixo de 0.5, a análise fatorial geralmente não é recomendada. Também podemos calcular o índice para cada variável, incluindo nos somatórios apenas os pares em que ela aparece. Essa versão ajuda a identificar quais variáveis se ajustam menos à estrutura de fatores comuns e merecem ser reavaliadas antes de prosseguir.
Podemos aplicar esses diagnósticos aos dados do Big Five preparados no Exemplo 6.7.
Código
from factor_analyzer.factor_analyzer import (
    calculate_bartlett_sphericity,
    calculate_kmo,
)

qui2_bartlett, p_bartlett = calculate_bartlett_sphericity(dados)
kmo_variavel, kmo_total = calculate_kmo(dados)

print(f"Bartlett: qui-quadrado = {qui2_bartlett:.0f}, p-valor = {p_bartlett:.1e}")
print(f"KMO global: {kmo_total:.3f}")
print(f"Menor KMO por variável: {kmo_variavel.min():.3f} ({itens[kmo_variavel.argmin()]})")
Bartlett: qui-quadrado = 18146, p-valor = 0.0e+00
KMO global: 0.849
Menor KMO por variável: 0.754 (A1)O teste de Bartlett rejeita a hipótese de que todas as correlações entre itens distintos sejam nulas, mas esse resultado não basta para avaliar a adequação à análise fatorial, sobretudo com uma amostra deste tamanho. O KMO global de 0.849 indica boa adequação, e mesmo o menor KMO individual fica bem acima de 0.5. Esses resultados apoiam o uso da análise fatorial para os dados.
6.8.2 Análise fatorial confirmatória
Tudo o que fizemos até aqui é análise fatorial exploratória. Deixamos os dados dizerem quantos fatores existem e quais variáveis pesam em cada um, e só depois, olhando as cargas, atribuímos nomes. A rotação é parte dessa postura, já que serve para encontrar a orientação mais legível entre infinitas equivalentes.
A análise fatorial confirmatória inverte a ordem. A estrutura é especificada antes de ver os dados, a partir da teoria, tipicamente fixando em zero as cargas dos itens nos fatores a que eles não pertencem. No exemplo do Big Five, isso significaria declarar que os cinco itens de neuroticismo carregam apenas no fator de neuroticismo, e assim por diante. Com cargas fixadas, a indeterminação rotacional desaparece, não há o que rotacionar, e o modelo fica bem mais fácil de testar. Ou ele reproduz a matriz de correlações observada, ou não.
O ajuste é avaliado pelo teste da Equação 6.3 e por índices construídos para contornar a sensibilidade daquele teste ao tamanho da amostra. A análise fatorial confirmatória é o caso mais simples dos modelos de equações estruturais, que permitem ainda especificar relações entre os próprios fatores latentes.
6.8.3 Dados ordinais e correlações policóricas
O exemplo deste capítulo tratou respostas em escala de 1 a 5 como se fossem contínuas, e calculou correlações de Pearson entre elas, como é usual. Uma escala Likert, porém, não é contínua nem tem espaçamento garantido entre categorias, e a correlação de Pearson entre variáveis ordinais é sistematicamente atenuada em relação à correlação entre as variáveis contínuas que as originaram, especialmente quando as respostas se concentram nos extremos.
A alternativa é a correlação policórica, que supõe que por trás de cada resposta ordinal existe uma variável contínua normal, cortada em faixas por limiares desconhecidos, e estima a correlação entre essas variáveis latentes por máxima verossimilhança. A análise fatorial é então conduzida sobre a matriz de correlações policóricas. O efeito prático costuma ser um aumento das comunalidades e, com alguma frequência, uma estrutura mais limpa. Em troca, a estimação é mais pesada e exige amostras maiores para ser estável.
Com poucas categorias, digamos duas ou três, a diferença é grande e compensa usar a correlação policórica. Com cinco ou mais categorias e respostas razoavelmente distribuídas, como no exemplo do Big Five, a atenuação é modesta e a análise sobre correlações de Pearson tende a levar às mesmas conclusões.
6.8.4 A análise fatorial como modelo probabilístico
A ACP probabilística, mencionada na Seção 4.11.5, supõe que a variância descartada se distribui igualmente por todas as direções não retidas, com \(\boldsymbol{\Sigma}= \boldsymbol{E}_q(\boldsymbol{\Lambda}_q - \sigma^2\boldsymbol{I}_q)\boldsymbol{E}_q^T + \sigma^2\boldsymbol{I}_p\), isto é, um único nível de ruído \(\sigma^2\) comum a todas as variáveis. A análise fatorial surge quando permitimos que cada variável tenha o seu próprio nível de ruído, trocando \(\sigma^2\boldsymbol{I}_p\) pela matriz diagonal \(\boldsymbol{\Psi}\).
Com um único nível de ruído para todas as variáveis, a ACP probabilística, tal como a ACP usual, depende da escala em que cada variável foi medida, e por isso precisamos padronizar antes de aplicá-la. Já \(\boldsymbol{\Psi}\) pode absorver diferenças de escala variável a variável, e é daí que vem a invariância de escala da solução de máxima verossimilhança da análise fatorial, vista na seção de estimação.